

Парсинг сайтов (с преодолением защиты)
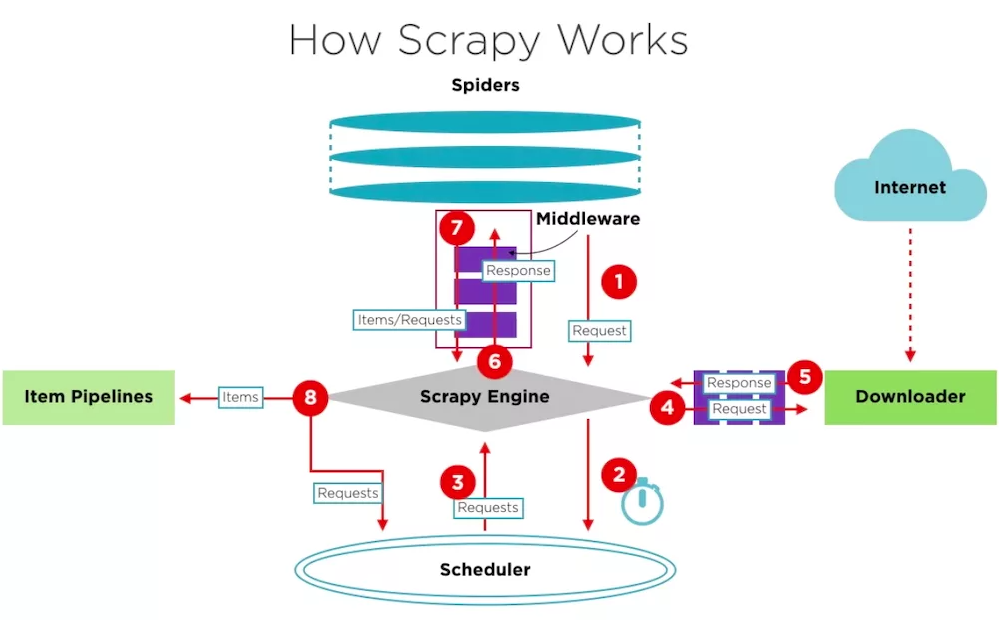
Стек технологий: Selenium, Splash, Scrapy, SpiderKeeper, Scrapyd
Товары, вакансии, резюме, котировки и подобное.
Автоматизированный сбор данных из веб-сайтов.
Эффективное решение для парсинга данных любой сложности.
Функциональные возможности и особенности
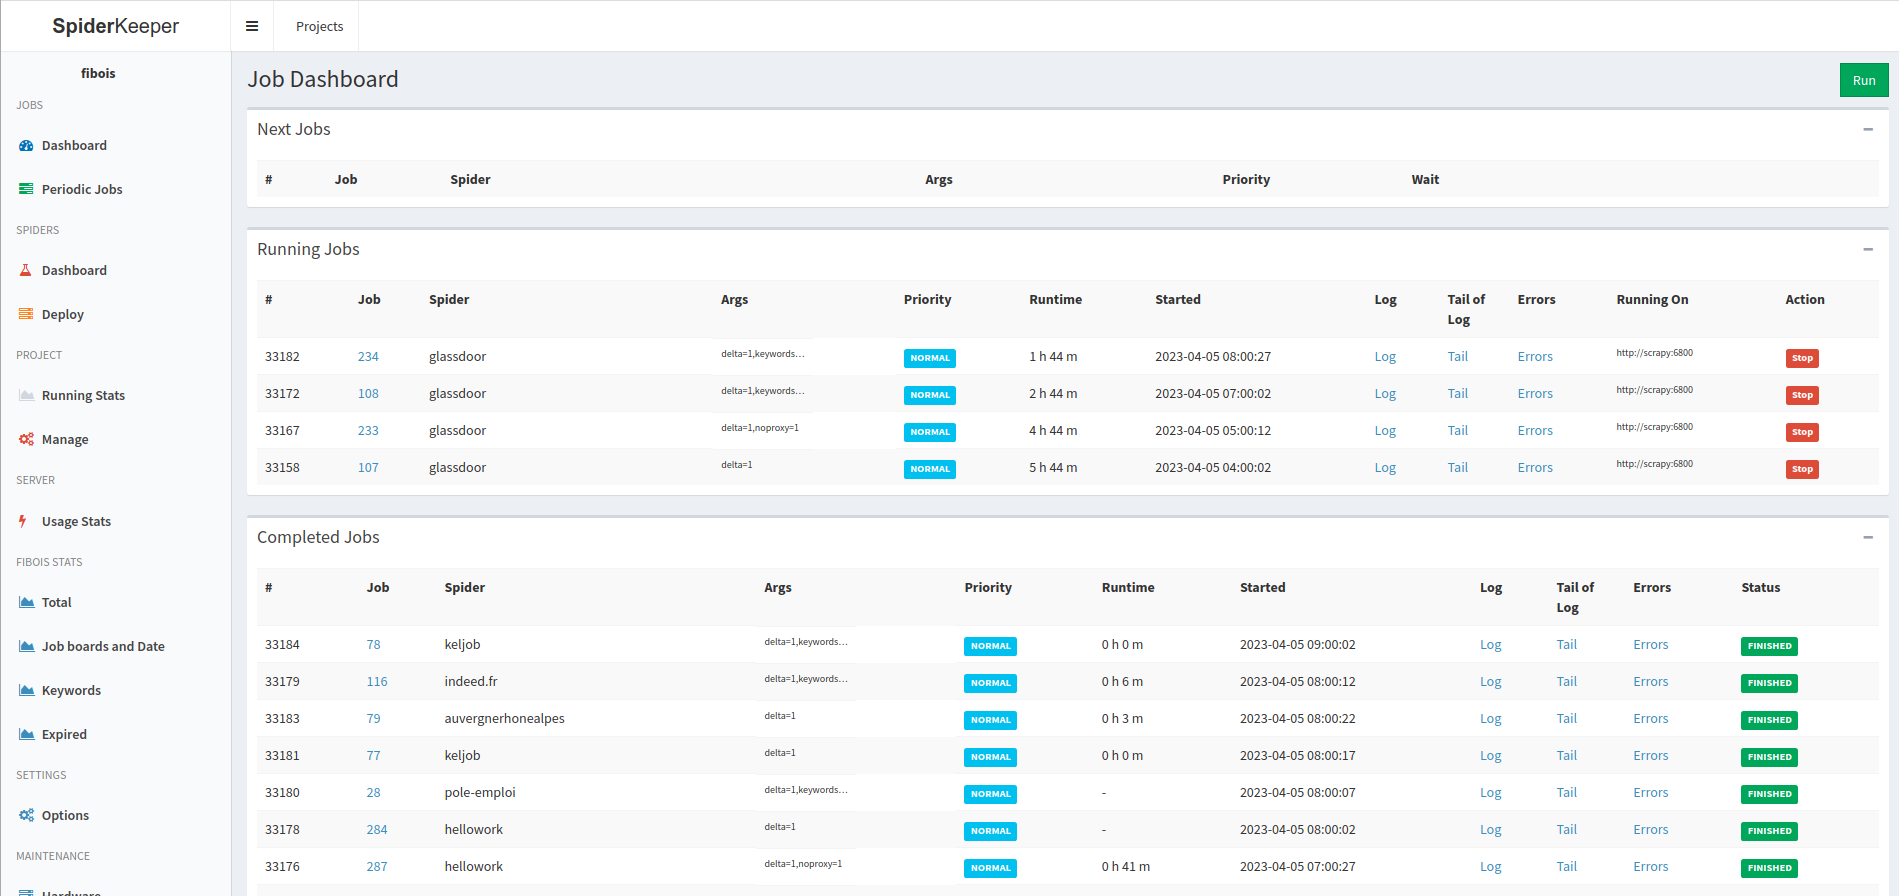
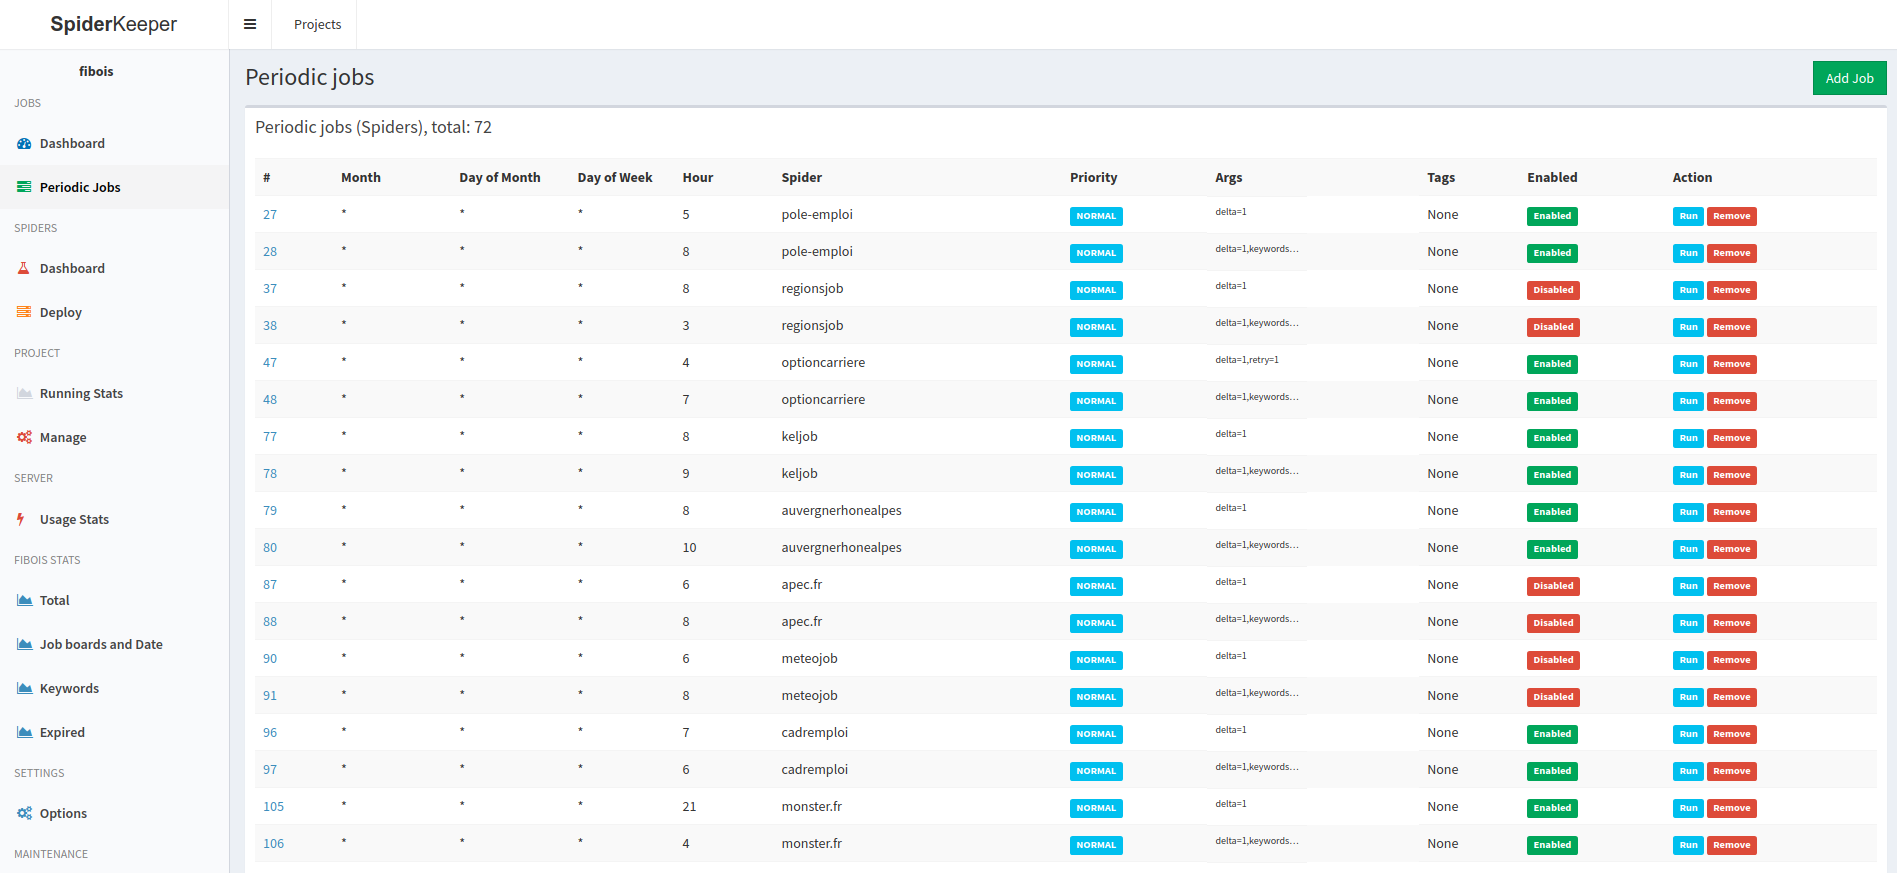
• Планирование и управление задачами:
• Запуск сбора данных по расписанию (ежедневно, еженедельно, ежемесячно) с возможностью настройки времени и приоритета.
• Визуализация статуса задач :
• Отслеживание состояния запущенных и завершенных задач парсинга, просмотр логов и статистики.
• Управление пауками :
• Загрузка, редактирование и удаление скриптов парсеров (пауков) Scrapy.
• Развертывание проектов:
• Удобное развертывание новых версий парсеров на сервере Scrapyd.
• Мониторинг ресурсов (Usage Stats):
• Контроль использования ресурсов сервера (CPU, память) для оптимизации работы парсеров.
Интерфейс системы «Парсинг сайтов с преодолением комплексной защиты» — экран 2
Интерфейс системы «Парсинг сайтов с преодолением комплексной защиты» — экран 3
Целевая аудитория и пользователи
• Для тех кто нуждается в регулярном сборе и анализе данных с веб-сайтов.
• Для тех кто занимается мониторингом цен, вакансий, резюме, котировок и другой публичной информации.
• Кто автоматизирует рутинные задачи по сбору данных для бизнеса, исследований или личных целей.
• Для людей которые разрабатывают собственные парсинговые решения на базе Scrapy.
• Для тех кто ищет удобный инструмент для управления и контроля запущенных парсеров.
Архитектура и используемые технологии
Технологический стек: Selenium, Splash, Scrapy, SpiderKeeper, Scrapyd
Frontend: Next.js (обеспечивает быструю загрузку страниц и отзывчивый интерфейс благодаря рендерингу на стороне сервера и возможностям React).
Backend: Python и фреймворк Django (для надежной и масштабируемой серверной части, отвечающей за обработку запросов и управление данными).
Базы данных: PostgreSQL (применяется для хранения структурированных данных, обеспечивая надежность, целостность и производительность).
Инфраструктура: Docker (используется для контейнеризации приложения, упрощая развертывание, масштабирование и управление зависимостями в различных окружениях).
Польза и результаты для бизнеса
Экономит ваше время и силы, автоматизируя процесс сбора данных. Получайте нужную информацию быстро и без ручного труда, принимайте обоснованные решения на основе актуальных данных и будьте на шаг впереди конкурентов.
Обсудить похожий проект
Хотите разработать аналогичное решение или получить экспертную консультацию по вашему проекту? Свяжитесь с нами, и мы подготовим коммерческое предложение.
Запросить коммерческое предложение